





Контекстний і персоналізований переклад: як JotMe використовує ваші дані для передавання нюансів

Точний переклад — одна з головних цілей JotMe. На щоденних чи щотижневих зустрічах ви можете обговорювати інформацію, помилка в якій дорого коштує. У цьому авторському матеріалі я поясню, чому ми приділяємо точності стільки уваги; твердження про головну причину вибору клієнтів не є опублікованим результатом незалежного опитування.
Чому ж переклад зі ШІ іноді не передає потрібного змісту, навіть коли речення граматично правильне?
Хочу відкрито пояснити, як ми описуємо використання даних для перекладу у вашому робочому контексті. Доступність окремих джерел залежить від функції та облікового запису; цей огляд не замінює політику конфіденційності й налаштування доступу.
Багато платформ уже можуть створювати граматично правильні переклади. Проблема часто в іншому: те саме речення має кілька доречних перекладів залежно від ситуації. Без контексту ШІ може не знати, що саме ви хочете сказати та яку інформацію співрозмовник уже отримав. Тому правильна граматика ще не означає правильно переданий намір.
Розгляньмо англійську фразу:
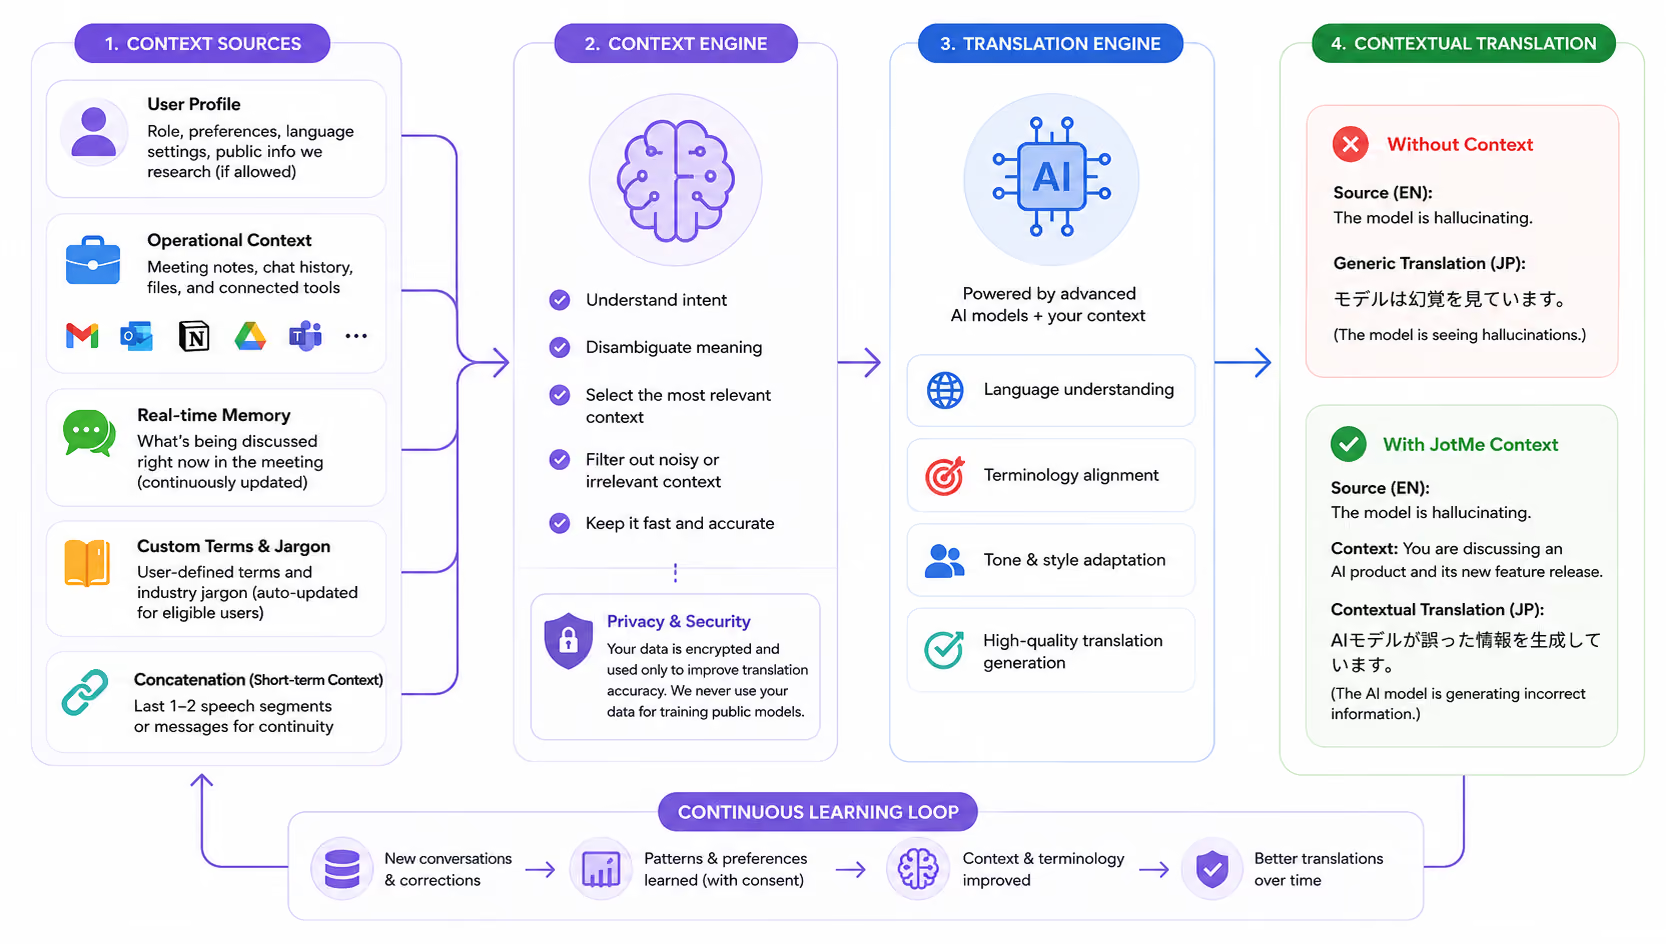
«The model is hallucinating» — «Модель галюцинує»
Без контексту слово «model» може означати людину, яка працює моделлю й переживає галюцинації, наприклад після вживання речовин. В обговоренні ШІ йдеться про модель, що генерує неправдиву інформацію. Перекладач має розрізнити ці значення.
Якщо перекладач має доречний контекст про вашу роботу над ШІ-продуктом і новими функціями, він може вибрати друге значення. Це допомога у визначенні змісту, а не гарантія безпомилкового висновку.
Приклад простий. У довгій розмові з багатьма учасниками, темами й попередніми домовленостями визначити потрібний контекст значно складніше.
Тепер поясню, які джерела контексту описано в JotMe та як вони можуть допомагати точніше передавати зміст.
Два типи перекладу в JotMe
У цьому матеріалі розрізняємо два процеси:
- Переклад наживо — текстові субтитри й озвучений переклад у підтримуваних режимах
- Переклад тексту — транскрипти, введений текст і листування
Як переклад наживо використовує контекст
Авторський опис виділяє такі джерела контексту; їхня доступність не є однаковою для кожного користувача:
Профіль користувача
Інформація, яку JotMe отримує про вас під час входу й користування платформою. У вихідному матеріалі також описано можливе дослідження публічно доступних відомостей у вебі за допомогою ШІ-агентів. Це не означає доступ до приватних сайтів або автоматичне застосування такої функції до кожного акаунта; поточні умови слід перевіряти окремо.
Робочий контекст
Відомості про вашу поточну роботу. Автор описує їх формування з нотаток зустрічей, повідомлень у JotMe Chat, завантажених файлів і взаємодій із JotMe AI. Конкретні джерела залежать від доступного процесу; це не твердження, що будь-який файл чи повідомлення завжди потрапляє до кожного перекладу.
Для користувачів із відповідним доступом вихідний матеріал також описує підключення Gmail, Outlook, Notion, Google Drive і Microsoft Teams для збагачення робочого контексту. Не слід вважати всі ці підключення доступними кожному акаунту або джерелом даних без належного підключення й дозволів; перевірте чинну доступність і налаштування.
Пам’ять поточної зустрічі
Короткий контекст того, що зараз обговорюють на зустрічі. Він оновлюється в міру розвитку розмови в підтримуваному процесі; це не обіцянка зберігати кожну деталь без пропусків.
Власні терміни й професійна лексика
Користувачі можуть додавати імена, назви, скорочення та галузеві терміни до власного словника. У поточних налаштуваннях термін належить до реєстру вихідної мови; точне написання й активність запису допомагають його застосуванню.
Для користувачів із відповідним доступом авторський опис передбачає також автоматичне оновлення термінології на основі робочого контексту. Це окремий процес, а не гарантія автоматичної зміни кожного ручного запису.
Зв’язок із попередніми фрагментами мовлення
У вихідному описі до поточного перекладу додається один або два попередні перекладені фрагменти, щоб зберігати зв’язність розмови. Це пояснення підходу, а не незмінна кількість для кожної моделі та режиму.
Як переклад тексту використовує контекст
Підхід подібний, але замість пам’яті поточного мовлення використовується контекст листування та попередні повідомлення. Доступність і обсяг контексту залежать від відповідної функції.
Профіль користувача
Інформація, яку JotMe отримує про вас під час входу й користування платформою. У вихідному матеріалі також описано можливе дослідження публічно доступних відомостей у вебі за допомогою ШІ-агентів. Це не означає доступ до приватних сайтів або автоматичне застосування такої функції до кожного акаунта; поточні умови слід перевіряти окремо.
Робочий контекст
Відомості про вашу поточну роботу. Автор описує їх формування з нотаток зустрічей, повідомлень у JotMe Chat, завантажених файлів і взаємодій із JotMe AI. Конкретні джерела залежать від доступного процесу; це не твердження, що будь-який файл чи повідомлення завжди потрапляє до кожного перекладу.
Для користувачів із відповідним доступом вихідний матеріал також описує підключення Gmail, Outlook, Notion, Google Drive і Microsoft Teams для збагачення робочого контексту. Не слід вважати всі ці підключення доступними кожному акаунту або джерелом даних без належного підключення й дозволів; перевірте чинну доступність і налаштування.
Пам’ять розмови
Контекст поточного листування, який оновлюється в міру обміну повідомленнями. Він допомагає враховувати попередні уточнення, але важливі факти все одно варто підтверджувати.
Власні терміни й професійна лексика
Користувачі можуть додавати імена, назви, скорочення та галузеві терміни до власного словника. У поточних налаштуваннях термін належить до реєстру вихідної мови; точне написання й активність запису допомагають його застосуванню.
Для користувачів із відповідним доступом авторський опис передбачає також автоматичне оновлення термінології на основі робочого контексту. Це окремий процес, а не гарантія автоматичної зміни кожного ручного запису.
Зв’язок із попередніми повідомленнями
У вихідному описі використовуються одне або два попередні повідомлення, щоб перекладене листування залишалося зв’язним. Це опис підходу до контексту, а не гарантія однакового вікна пам’яті в усіх процесах.
ШІ покращив переклад, але простір для вдосконалення залишається
Якість перекладу зі ШІ помітно зросла, проте неоднозначність і брак потрібного контексту залишаються проблемою.
Як показує приклад вище, одне речення можна перекласти кількома способами. Без достатньої інформації ШІ може не визначити задум мовця або очікування слухача.
Просто додати якомога більше контексту теж недостатньо. Надлишкові або недоречні дані можуть ускладнювати пошук важливого — це пов’язують із явищем context rot, або погіршенням роботи з довгим контекстом. Дослідження цього явища стосуються конкретних моделей і задач; вони не є прямим виміром точності JotMe.
Є й компроміс зі швидкодією. Переклад наживо має надходити під час розмови, а обробка більшого обсягу контексту може збільшувати час формування результату. Вплив залежить від моделі й процесу.
У наших описаних дослідницьких експериментах деякі результати з’являлися більш ніж через 30 секунд. Для звичного темпу живої розмови така затримка була неприйнятною; це спостереження з експериментів, а не заявлений поточний час роботи платформи.
За спостереженнями нашого тестування, затримка приблизно 1–5 секунд могла залишати достатньо часу для контексту й водночас бути прийнятною для більшості залучених користувачів. Це авторський досвід без опублікованої тут вибірки, а не гарантований час відповіді або SLA для всіх мов, мереж і режимів.
Знайти правильний баланс між контекстом, швидкістю й точністю — одна з головних дослідницьких задач, над якими ми працюємо в JotMe.
Ми й надалі інвестуватимемо в цю роботу, щоб допомагати компаніям отримувати точніший переклад зі ШІ. Це напрям розвитку, а не гарантія найвищої точності на будь-якому матеріалі.
До наступної зустрічі!
Спробуйте JotMe
Точний переклад для зустрічей, заходів і щоденної роботи. AI Memory пам’ятає ваш контекст.


