






準確翻譯是 JotMe 重視的核心。每天或每週的會議,常有需要仔細確認的重要資訊;作者認為,這也是客戶選擇 JotMe 的重要原因。這裡的品牌與客戶觀察,不是獨立準確率排名,也不代表翻譯不會出錯。
既然都使用 AI,為什麼翻譯還可能不夠貼切?
這篇文章想說明 JotMe 如何運用與工作相關的資料,協助翻譯貼近實際流程。以下保留作者描述的資料類型與研究方向;各項用途仍須按可用功能、帳戶資格、設定及隱私政策確認。
不少翻譯在文法上已經通順,不一定是字面錯誤。關鍵在於,同一句話會隨上下文有不同譯法。如果 AI 不知道你想傳達什麼,或聽者先前已掌握哪些資訊,結果就可能不符合當下意思。
例如這句英文:
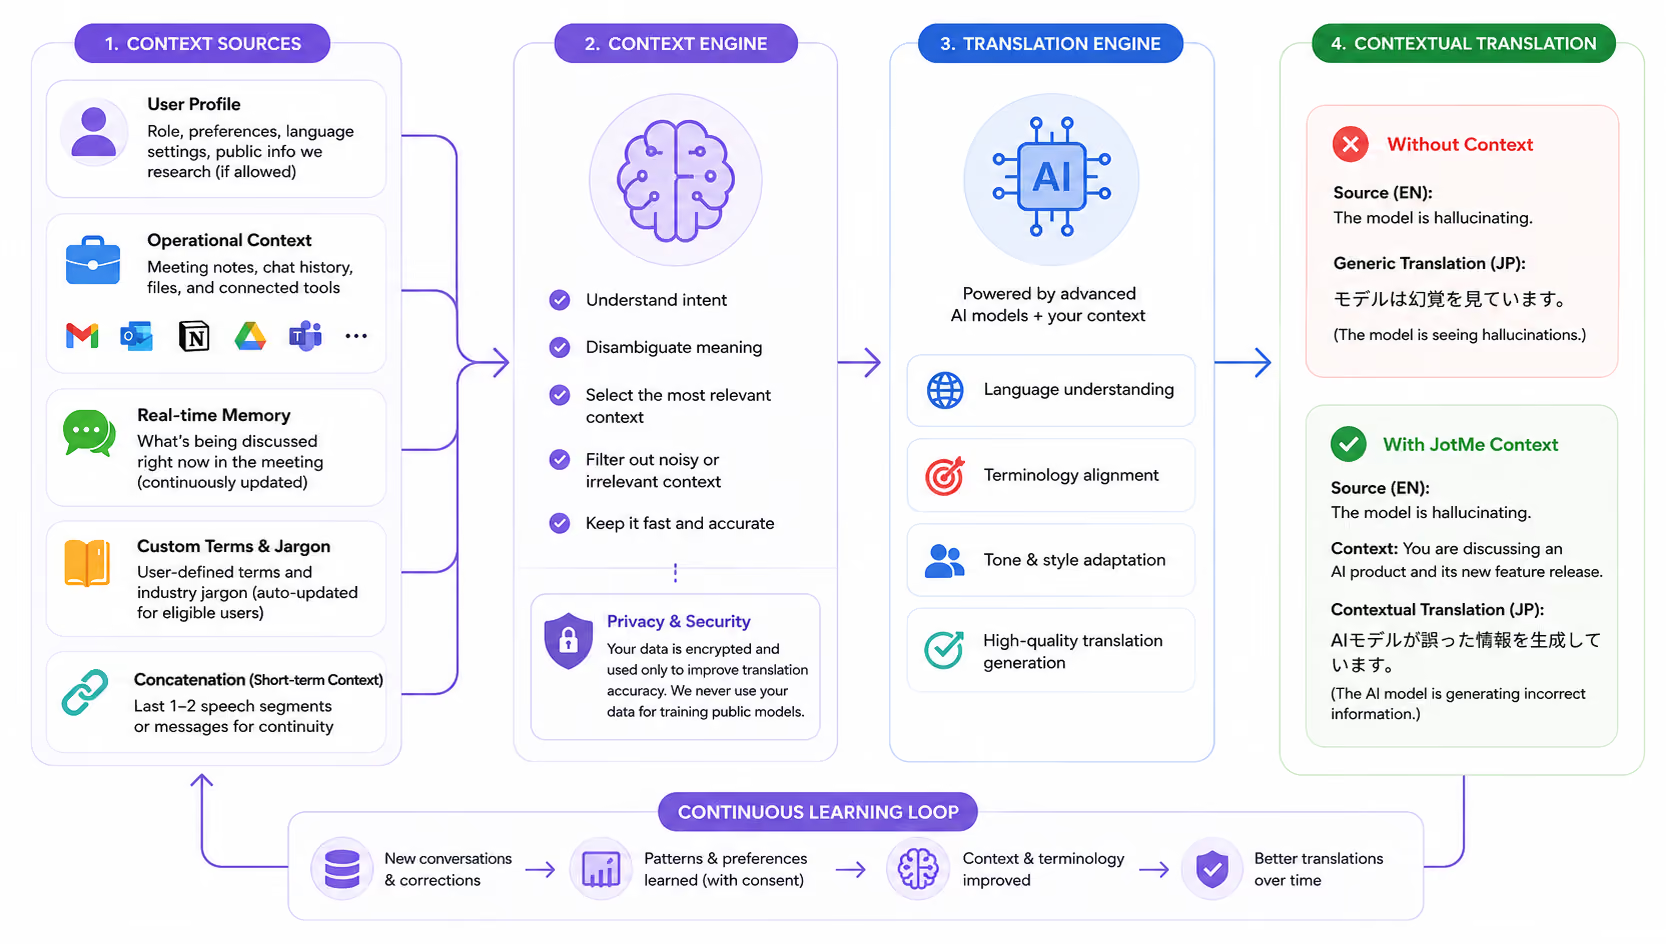
「The model is hallucinating.」
缺少上下文時,model 可能是指一位出現幻覺的模特兒,也可能是指產生不實資訊的 AI 模型。原文以用藥後的模特兒作為其中一種情境,重點是同一個字可能有不同指涉。
如果翻譯系統知道你正在開發 AI 產品、討論 AI 功能,就較有依據選擇「AI 模型產生不實內容」的意思;上下文能協助判斷,但不能保證每次都選對。
這只是簡單例子;當對話更複雜、涉及更多資訊時,判斷語意也會更困難。
了解這點後,接著看作者如何描述 JotMe 使用上下文,協助產生更準確的翻譯。
JotMe 的兩類翻譯情境
本文把 JotMe 的翻譯用途分為兩類:
- 即時翻譯:在支援模式中提供即時字幕或語音對語音翻譯
- 文字翻譯:處理逐字稿、輸入文字與聊天等內容;各功能的語言與權限另確認
即時翻譯如何參考上下文?
原文介紹以下幾種上下文來源;不表示每個帳戶或模式都會同時使用全部資料。
使用者設定檔
原文把登入後取得、與使用者相關的資訊列為一種來源,也提到 AI 代理可能查閱網路上的公開資訊來協助翻譯。這項產品說明不等於能存取私人網站,或所有帳戶都預設啟用;實際範圍需依功能、設定與隱私政策確認。
工作上下文
作者描述的工作上下文,可能來自會議記錄、JotMe Chat 訊息、上傳檔案,以及與 JotMe AI 的互動。是否納入某項內容,須按實際功能與資料控制確認,不能把整個帳戶資料都視為自動通用的翻譯輸入。
原文也提到,符合資格的使用者可連接 Gmail、Outlook、Notion、Google Drive 或 Microsoft Teams 等工作服務,補充工作脈絡。這不是所有帳戶皆已提供每項連接器的承諾;仍須確認實際可用整合、授權與存取範圍。
即時記憶
這裡指的是會議當下正在討論的內容,會隨對話演進更新,協助理解後面的發言;它與長期保存、訓練模型或分享資料是不同問題。
自訂詞彙與產業術語
使用者可加入重要名稱、專有詞彙與產業術語。現行自訂詞彙文件說明,應放在對應的來源語言清單,並依支援功能套用;這有助辨識與保留用詞,仍不是零誤差保證。
原文另描述,部分符合資格的使用者可利用工作上下文更新詞彙。這與一般手動管理詞彙不同,是否提供自動更新仍須按帳戶與功能確認。
銜接先前的語音片段
作者介紹的做法,是參考前一至兩段已翻譯內容,讓後續翻譯較連貫;這是本文描述的處理方式,不代表所有模式固定使用完全相同的片段數。
文字翻譯如何參考上下文?
文字翻譯採用相近思路,但會以對話記憶與先前訊息,取代即時收音情境中的語音記憶;實際取用範圍依功能而異。
使用者設定檔
原文把登入後取得、與使用者相關的資訊列為一種來源,也提到 AI 代理可能查閱網路上的公開資訊來協助翻譯。這項產品說明不等於能存取私人網站,或所有帳戶都預設啟用;實際範圍需依功能、設定與隱私政策確認。
工作上下文
作者描述的工作上下文,可能來自會議記錄、JotMe Chat 訊息、上傳檔案,以及與 JotMe AI 的互動。是否納入某項內容,須按實際功能與資料控制確認,不能把整個帳戶資料都視為自動通用的翻譯輸入。
原文也提到,符合資格的使用者可連接 Gmail、Outlook、Notion、Google Drive 或 Microsoft Teams 等工作服務,補充工作脈絡。這不是所有帳戶皆已提供每項連接器的承諾;仍須確認實際可用整合、授權與存取範圍。
對話記憶
這裡指聊天中持續累積的討論脈絡,可隨對話更新,協助譯文貼近主題。它不表示會把所有其他聊天或私人內容一併提供給每位參與者。
自訂詞彙與產業術語
使用者可加入重要名稱、專有詞彙與產業術語。現行自訂詞彙文件說明,應放在對應的來源語言清單,並依支援功能套用;這有助辨識與保留用詞,仍不是零誤差保證。
原文另描述,部分符合資格的使用者可利用工作上下文更新詞彙。這與一般手動管理詞彙不同,是否提供自動更新仍須按帳戶與功能確認。
銜接先前的聊天訊息
作者描述會參考前一至兩則訊息,協助維持譯文的連貫與自然。訊息保留、分享與使用範圍仍應分別確認。
AI 翻譯進步了,還有哪些落差?
AI 讓翻譯有了很大進展,但仍可能出現理解落差。
同一句話可能有不同譯法;沒有足夠上下文,AI 就缺少判斷說話者意圖或聽者預期的依據。
但上下文也不是越多越好。過多或不相關的內容,可能讓模型更難找到關鍵資訊,這類現象常被稱為上下文退化(context rot)。長上下文研究顯示,表現會受模型、任務與資訊配置影響,不能把它當成所有翻譯都有同一條固定界線。
即時翻譯也需要權衡速度。加入更多上下文可能增加處理時間,實際影響仍依模型、輸入、模式與系統條件而異。
作者表示,研究中的某些實驗超過 30 秒才產生結果,難以用於即時對話。這是當時的實驗觀察,不是現行所有流程的延遲數據。
原作者的測試認為,約 1–5 秒的延遲可在部分使用情境中兼顧上下文與對話節奏。來源沒有提供完整受試者或量測方法,因此不把它當成大多數使用者的普遍結論、服務時效或準確度保證。
如何在上下文、速度與準確度之間找到合適平衡,是 JotMe 持續研究的核心問題之一。
我們會持續投入這項工作,協助企業取得更準確、也更貼近實際需求的 AI 翻譯。
下次見。


